消費者研究每年耗費企業數十億美元,卻長期受制於人類受訪者的討好傾向與正面偏誤。大型語言模型(LLM)作為模擬消費者(Synthetic Consumers)的應用,因此引發廣泛期待——但可靠性爭議也隨之升溫。2025 至 2026 年間,三篇論文形成了一場罕見的方法論三重奏:PyMC Labs 研究回答「如何正確引導模型」,哥倫比亞大學研究接著問「引導之後如何校準偏誤」,而奧斯陸大學研究則直逼底層:「有些東西,AI 根本無法模擬。」三篇合讀,才構成一幅完整的技術版圖。
原理:引導、校準、邊界,三道防線
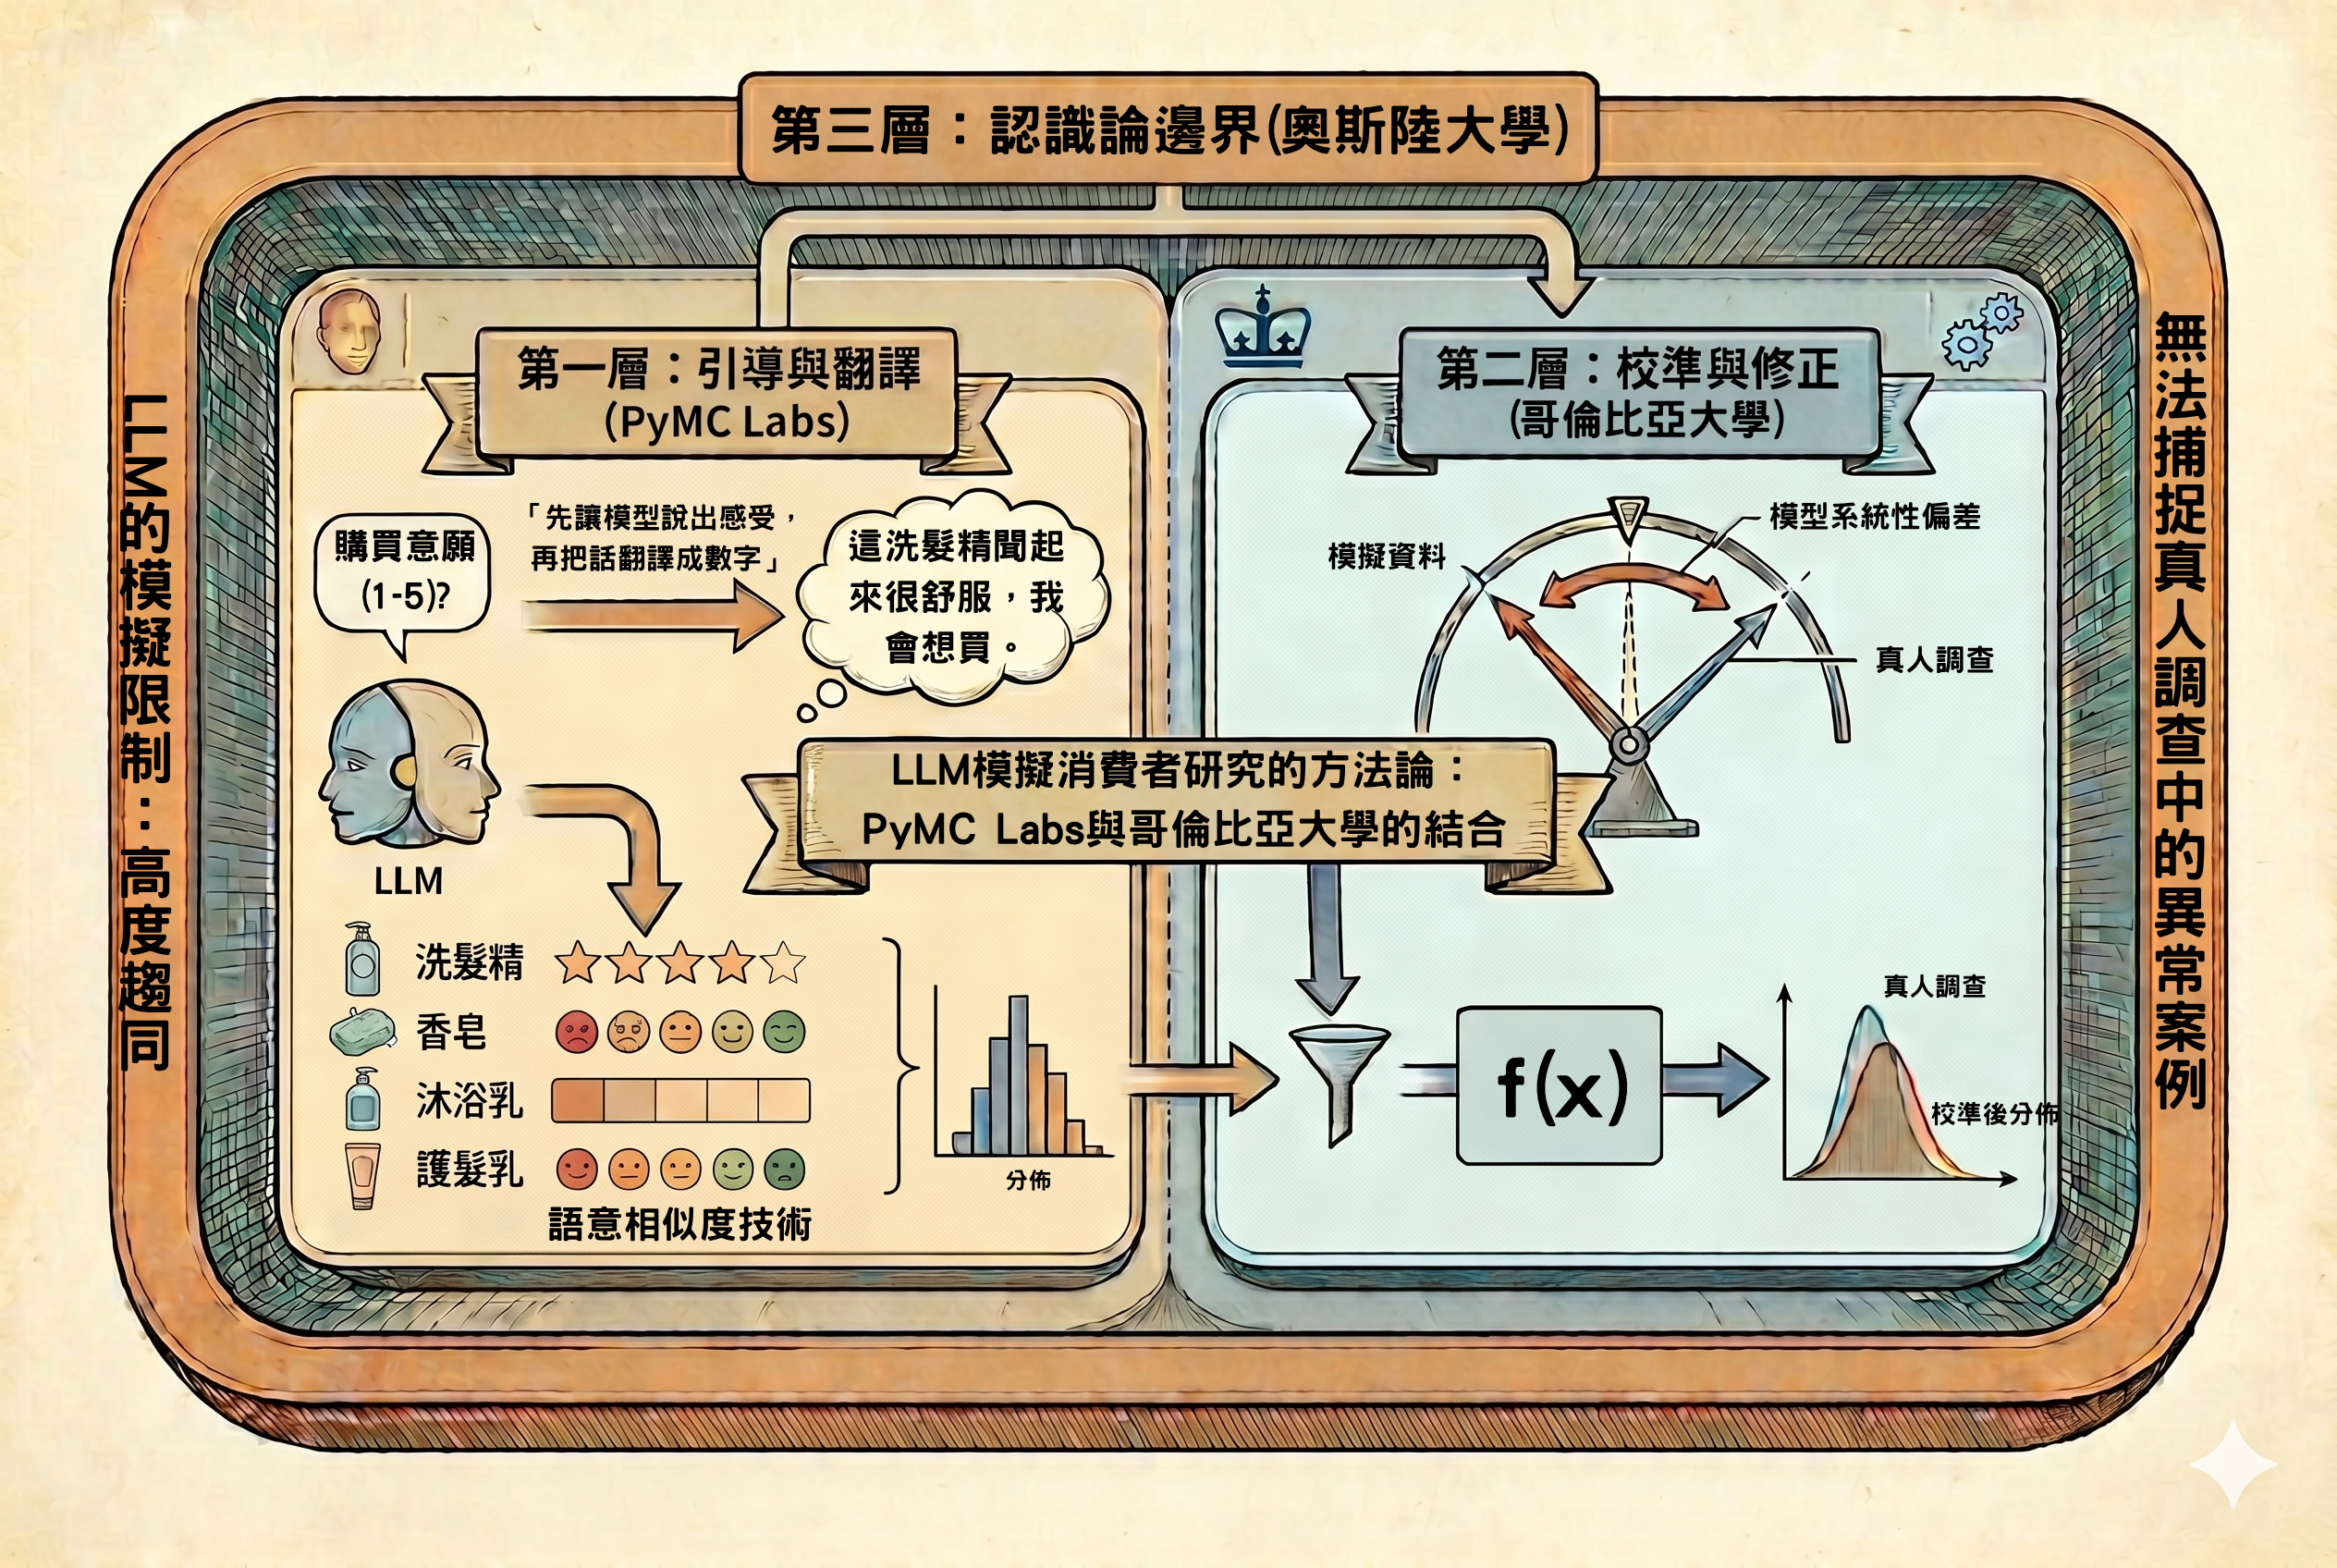
圖1:PyMC, 哥倫比亞與奧斯陸大學的研究概念示意圖
圖片來源:本文作者以AI生成
想像你要問一位 AI「你有多想買這瓶洗髮精」,最直覺的做法是讓它直接回答 1 到 5 分。但 PyMC Labs 研究發現這個做法幾乎無效——模型不管問什麼產品,幾乎都回答「3」,如同一個不置可否的受訪者,完全喪失辨別不同產品吸引力的能力。這篇研究的解法是真的換個問法:先讓模型說出感受,再把話翻譯成數字。具體做法是告訴模型「你是一位 35 歲、月收入中等的女性消費者」,請它看完產品圖文後自由說出購買意願,接著用語意相似度技術比對這段話與五個預設語句(從「非常想買」到「完全不考慮」)的接近程度,轉換出一個分布——而不是一個單一分數。
哥倫比亞大學研究則處理的是更深一層的問題:即便引導方式正確,LLM 本身就帶有訓練資料留下的系統性偏差,就像一把刻度不準的尺,量出來的數字需要再調整。它的做法是把過去已有真人回應的舊問題拿來當「參照錨點」,分析模擬資料與真人資料之間的偏差規律,再把這個修正邏輯套用到新問題上——整個校準過程不需要重新訓練模型,只是在輸出結果上加一層修正。
然而,奧斯陸大學研究指出上述兩層設計都無法解決的根本限制:LLM 的答案說到底是對訓練資料中「大多數人怎麼說」的統計複誦。研究者讓五個不同品牌的頂尖 LLM 各自模擬同一批人,五組模擬答案彼此高度相似,卻都與真實調查結果不符——五個模型像一個聲部,和諧地唱錯了同一首歌。真人調查中那些意料之外、最具洞察價值的發現,沒有任何一個模型能夠重現。
應用案例
案例一:保養品品牌,用 AI 先篩掉 17 個不該做的產品
某保養品牌計畫推出新品線,內部提出 20 個產品概念,從成分訴求到包裝故事各有不同。傳統做法是委託消費者研究公司辦焦點座談,光是三輪篩選就要花三個月、數百萬預算。套用 PyMC Labs 框架後,品牌設定五種目標客群人物設定(25–35 歲雙薪女性、40 歲以上熟齡保養族等),讓 AI 模擬消費者依序評估 20 份概念圖文,取得每個概念的購買意向分布,整個過程兩週內完成,20 個概念排序清楚,最後三名幾乎是一致的墊底。品牌接著把過去五年的歷史調查資料當錨點,套用哥倫比亞大學的校準邏輯,將 AI 輸出結果的系統偏差壓縮至可接受範圍,最終只有前三名概念進入實體座談,預算集中,轉化率反而更高。然而,奧斯陸大學研究的警示也在此現身:實體座談中有消費者說「這瓶看起來太像醫療器材,不想買」,這個設計語言問題直接推翻了 AI 排名第一的概念,而任何模擬消費者都沒有說出這句話。
案例二:電商平台,30 個新功能只能選三個
某中型電商平台產品部門累積了 30 個待開發功能構想,從「訂單集運」到「會員積點升級制」都有,但工程資源最多只能在下一季實作三個,各部門意見分歧。套用 PyMC Labs 框架設定三種主要用戶人物設定(學生族、家庭主婦、小型賣家),讓 AI 模擬消費者快速對 30 個功能打分排序;由於平台過去累積了多次真實用戶的調查資料,再以哥倫比亞大學的校準方法縮小模擬結果與真實行為的落差,最終選出的三個功能在後續 A/B 測試的採用率均高於歷史平均。但奧斯陸大學研究的天花板同樣清楚出現:AI 精準預測「免運門檻調整」受歡迎,卻完全沒有預測到真人訪談才挖出的洞察——有一群小型賣家希望平台「讓他們買到更多廣告版位限制」,以便控制自己的衝動消費行為。這種自我矛盾的需求,任何模擬消費者都不可能說出口。
產業趨勢:從工具競逐走向生態分工
三篇論文合讀,勾勒出一個正在形成的方法論分工生態:PyMC Labs 解決的是引導失真(直接問數字導致回答集中於中間值),哥倫比亞大學研究解決的是系統偏誤(模型固有偏差的事後修正),而奧斯陸大學研究劃定的是認識論邊界(模擬資料只能複製常識,不能發現矛盾的真實需求)。
這一生態對企業的啟示,遠比任何單一工具的效能數字更重要:模擬消費者研究適合「已知框架內的概念排序與規模篩選」,而不適合「發掘使用者尚未言明的潛在需求」或「找出市場中意料之外的機會」。
FIND 觀點:三層工具、三類任務,才是中小微企業的正確姿勢
理解這三篇研究的人,不會問「LLM 能不能取代消費者調查」,而是會問「哪一類任務交給哪一層工具最划算」。對於資源有限的中小微企業,這個問題尤其切身。
PyMC Labs 框架在零訓練資料的前提下達到九成人類信度,且論文明確指出此技術能讓過去無力負擔大規模消費者研究的小型企業觸及消費洞察。這是模擬消費者對中小微企業最直接的價值——以極低成本在十到數十個產品構想間快速排序,再集中資源驗證前幾名。哥倫比亞大學研究的校準邏輯則告訴我們:若企業已累積少量歷史真人調查資料,即可作為校準錨點,進一步壓縮模擬結果與真實市場的偏差,這對有過去調查存檔的台灣製造業或品牌業者尤具價值。
然而,奧斯陸大學研究的警示必須銘記:當決策需要仰賴出乎意料的洞察——例如某個族群對產品有意料之外的抗拒理由,或使用場景與設計預設完全不符——LLM 幾乎可以確定無法提供幫助。五大模型在同一真人資料面前集體輸出「有說服力但不準確的常識版本」,正是這類任務不可繞過真人的結構性原因。
對台灣在地部署而言,三篇論文共同揭露了一個目前尚未填補的空白:無論是供 PyMC Labs 框架使用的繁體中文 Likert 錨點語句庫、哥倫比亞大學研究所需的本地校準基準資料,還是奧斯陸大學研究所強調的意外洞察驗證機制,目前均找不到公開的台灣本地化消費者語料庫可直接套用。這意味著現階段導入三篇論文的方法,都必須先投入本地真人資料的建構成本,而這個前置工作本身,也是中小微企業評估是否跨入此技術時最需要納入的隱性門檻。
封面圖片來源:本文作者使用AI生成
參考資料來源:
1. LLMs Reproduce Human Purchase Intent via Semantic Similarity Elicitation of Likert Ratings(PyMC Labs 研究)— Benjamin F. Maier et al.(PyMC Labs & Colgate-Palmolive)
2.SYN-DIGITS: A Synthetic Control Framework for Calibrated Digital Twin Simulation(哥倫比亞大學研究)— Grace Jiarui Fan et al.(Columbia Business School & Columbia University)
3. Stochastic Parrots or Singing in Harmony? Testing Five Leading LLMs for their Ability to Replicate a Human Survey with Synthetic Data(奧斯陸大學研究)— Jason Miklian, Kristian Hoelscher, John Katsos(University of Oslo, PRIO, American University of Sharjah)