近年生成式 AI 快速發展,影像生成模型已能產出高解析、細節豐富且風格多元的圖片,從 Stable Diffusion 到 Diffusion Transformer,模型品質持續提升。而隨著模型架構持續演進,新的問題也逐漸浮現:影像生成模型變得越來越強,但也越來越耗費運算資源。
因此,近期影像生成研究開始關注一個更務實的問題:能否在有限運算資源下,讓模型更快學會生成,並維持甚至提升影像品質?REPA(Representation Alignment for Generation)便是這個方向中的代表方法之一。
REPA:讓生成模型借用既有視覺特徵
REPA 是近年影像生成模型訓練效率研究中的代表方法,核心概念是在影像生成模型訓練過程中加入「特徵對齊」機制,讓模型對齊預訓練視覺模型已學到的圖像特徵,以加速訓練並改善生成品質。
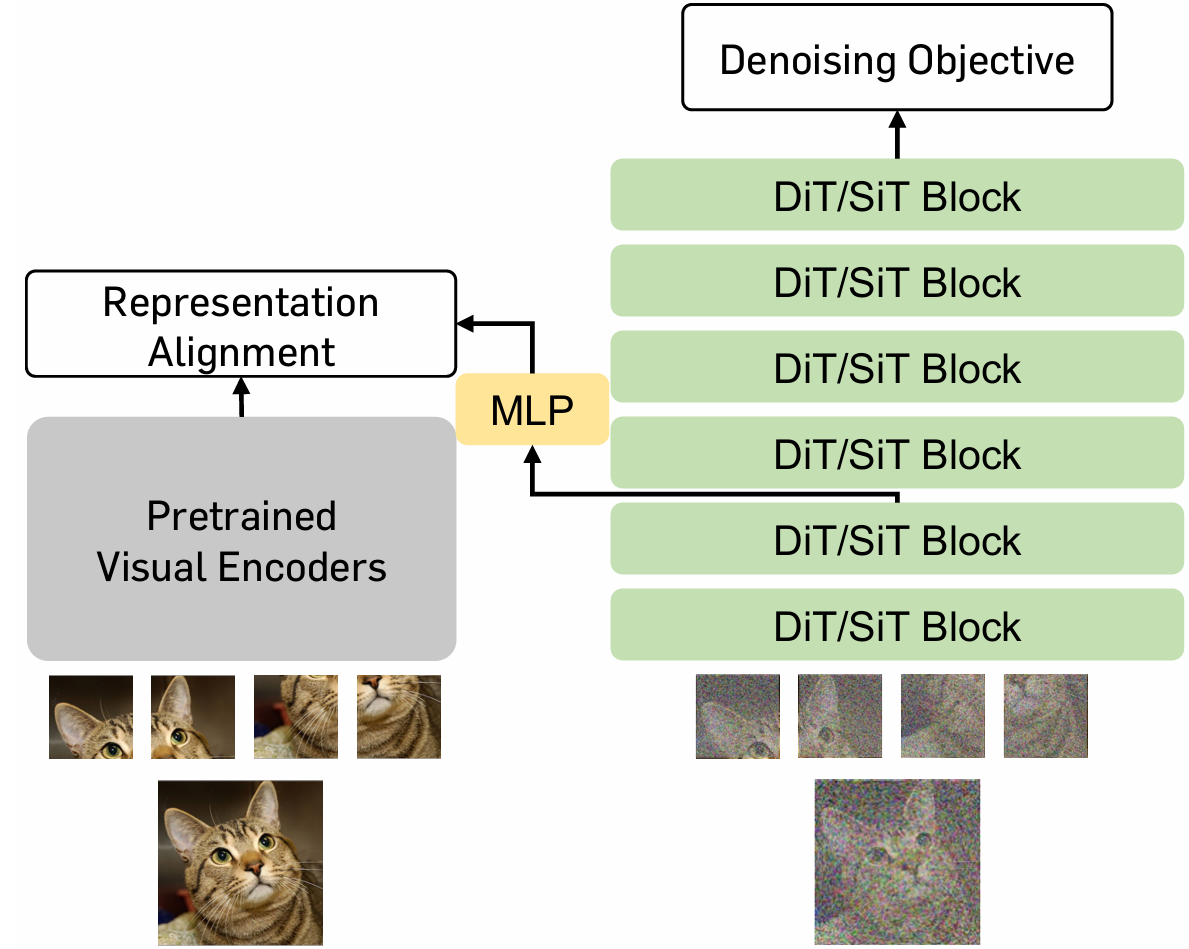
圖1: REPA 架構圖
圖片來源: https://arxiv.org/pdf/2410.06940
如圖所示,REPA 的架構主要分成兩條路徑,右側是原本的 DiT/SiT 影像生成模型,負責學習去噪生成任務,左側則是預訓練視覺編碼器,用來從乾淨影像中萃取較成熟的視覺特徵。
REPA 的關鍵在於中間的 representation alignment,模型會透過 MLP,將 DiT/SiT 中間層特徵投影到與預訓練視覺特徵相近的空間,並加入對齊損失。讓生成模型在學習去噪的同時,也能參考預訓練視覺模型的語意特徵。
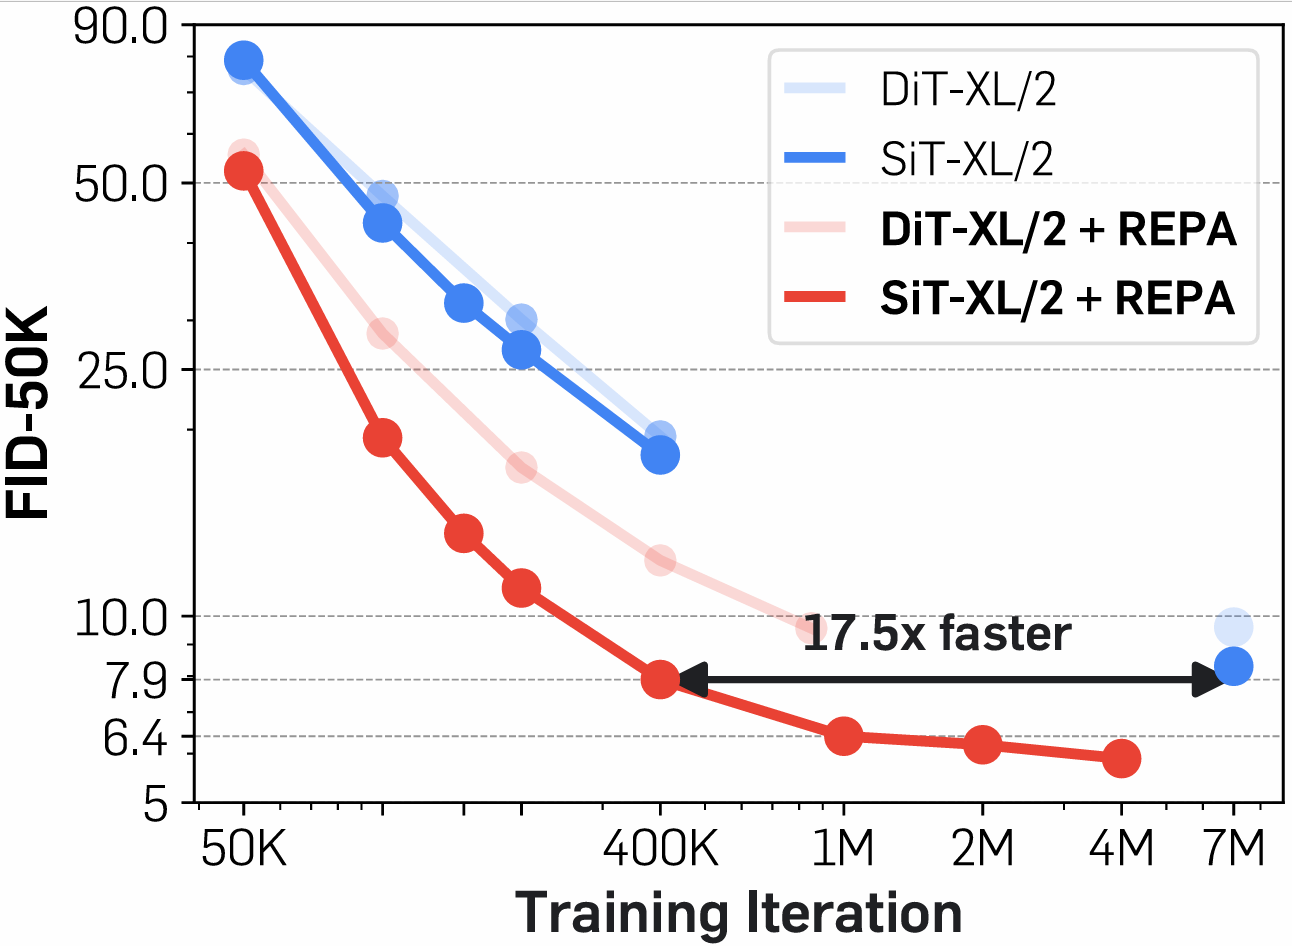
圖2 :REPA 對訓練效率的提升效果
圖片來源: https://arxiv.org/pdf/2410.06940
圖二主要呈現 REPA 對收斂速度的影響,根據Sihyun Yu於研究中指出,在 SiT 訓練中加入 REPA 後,模型可用不到 40 萬次訓練步數,達到原本 SiT-XL 約 700 萬次訓練步數的表現,訓練效率提升約 17.5 倍。
除此之外,Sihyun Yu也於研究中指出,REPA 在搭配 classifier-free guidance 與 guidance interval 後,最終可達到 FID 1.42 的生成品質。這代表影像生成模型的提升,不一定只能依靠更多資料與更多算力。若模型能有效利用外部視覺特徵,就有機會用更短訓練時間達到相近,甚至更好的生成效果。
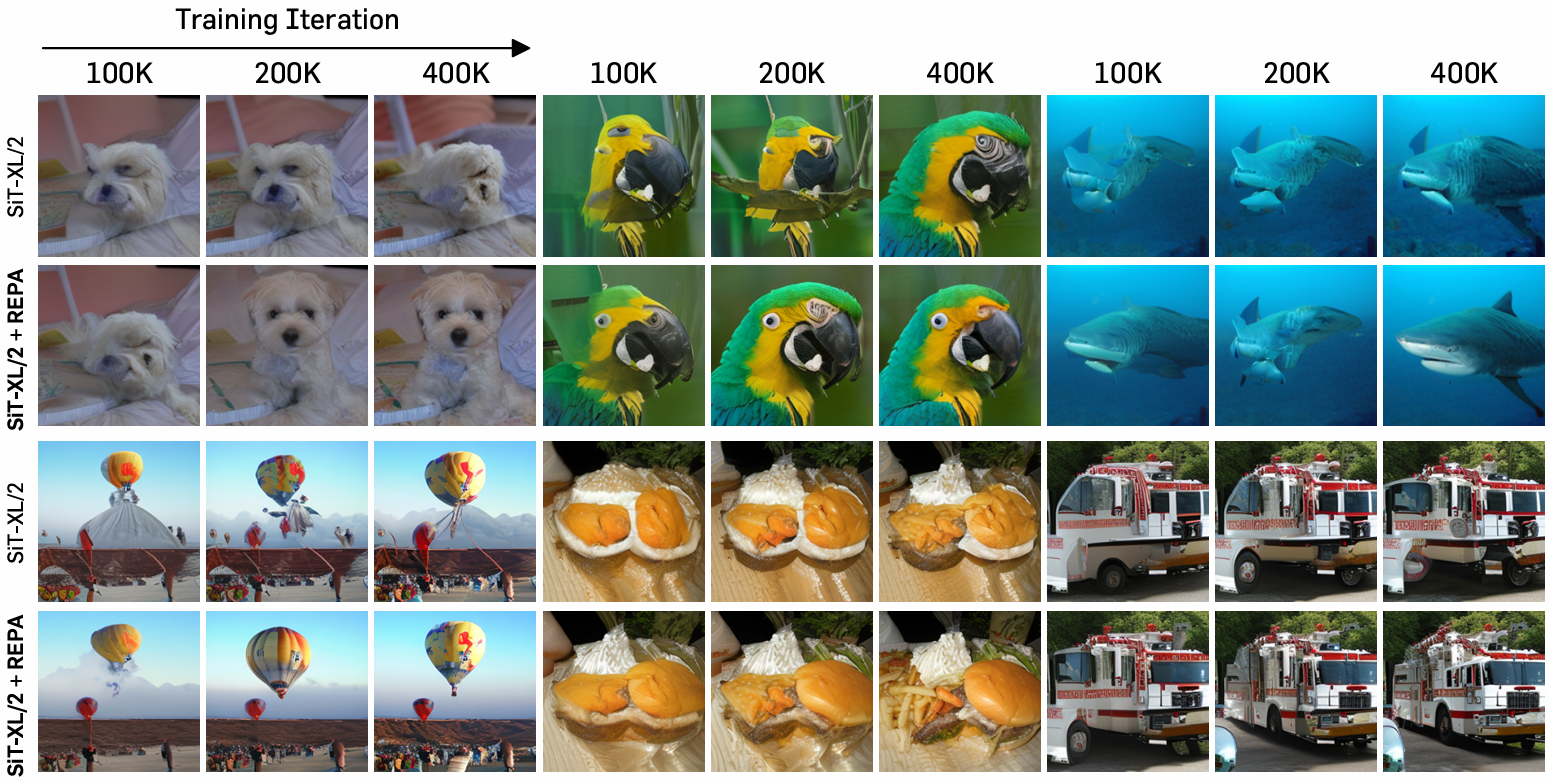
圖3 : 不同訓練步數下的生成結果比較
圖片來源: https://arxiv.org/pdf/2410.06940
從生成結果也可以看到,加入 REPA 後,模型在較少訓練步數下,就能生成結構較完整、細節較穩定的影像。
從單一特徵對齊走向更完整的視覺特徵
REPA 提出後,相關研究也開始延伸這個問題:只讓模型對齊局部特徵,是否已經足夠?影像生成並不只是在還原單一物件或局部細節,還包含整體結構、物件關係與畫面分布。因此,後續方法開始嘗試加入結構、多尺度或分布層級的對齊,讓生成模型不只學到局部特徵,也能掌握更完整的視覺特徵。
這個發展反映出影像生成研究的重點正在轉變,過去提升品質常被理解為擴大模型、增加資料或延長訓練時間,但現在也有越來越多研究關注:模型能不能更有效率地利用已經存在的視覺知識。
為什麼這件事重要?
從產業角度來看,訓練效率會直接影響影像生成技術的使用門檻。如果高品質模型只能依賴大型平台與大量算力,中小型團隊即使有自己的資料、風格或應用情境,也不容易進一步調整模型。
REPA 這類方法提供的價值,正在於它不是單純要求更多運算資源,而是嘗試讓模型在訓練過程中更有效地吸收預訓練視覺模型的特徵知識。當生成模型能更快學到可用的視覺特徵,就有機會在有限資源下提升訓練效率與生成品質。
因此,未來影像生成模型的競爭,可能不只是比誰的模型更大、資料更多,也會包含誰能更有效率地使用既有模型知識。從這個角度來看,特徵對齊方法不只是單一技術改良,也可能成為影像生成模型降低訓練成本的一條重要路徑。
封面圖片來源:本文作者以ChatGPT生成情境圖
參考資料來源:
1.Zheng et al., Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think, arXiv, 2024.
https://arxiv.org/pdf/2410.06940
2.SARA, Structural and Adversarial Representation Alignment for Training-efficient Diffusion Models, arXiv, 2025.
https://arxiv.org/pdf/2503.08253